
ทำไมคุณต้องเข้าใจ Tech Jargon ก่อนเริ่มงาน?
คุณเคยรู้สึก “งงๆ” หรือ “ตามไม่ทัน” ในห้องประชุมทีมเทคที่เต็มไปด้วยคำศัพท์แปลกๆ ที่ไม่เคยได้ยินมาก่อนไหม? 🤔
สำหรับมือใหม่และคนที่กำลังเปลี่ยนสายอาชีพเข้าสู่วงการเทคโนโลยี ปัญหาที่พบบ่อยที่สุดไม่ใช่การเขียนโค้ดหรือทักษะทางเทคนิค แต่เป็นการสื่อสารที่ผิดพลาด การกลัวที่จะถาม และสิ่งที่เรียกว่า Imposter Syndrome หรือความรู้สึกว่าตัวเองไม่เก่งพอ ไม่เหมาะสมที่จะอยู่ในวงการนี้ 😰
แต่รู้ไหมครับ? ความลับของการก้าวเข้าสู่วงการเทคอย่างมั่นใจไม่ได้อยู่ที่การรู้ทุกอย่าง แต่อยู่ที่การเข้าใจภาษาเดียวกันกับทีม
บทความนี้จะพาคุณไปทำความรู้จักกับ 50 คำศัพท์เทคโนโลยีสำคัญ ที่แบ่งออกเป็น 5 หมวดหมู่ ตั้งแต่การพัฒนาซอฟต์แวร์ การบริหารโปรเจกต์ ไปจนถึงความปลอดภัยและข้อมูล เพื่อให้คุณสามารถก้าวเข้าสู่อุตสาหกรรมนี้ด้วยความมั่นใจและพร้อมสื่อสารกับทีมได้อย่างราบรื่น 🚀
มาเริ่มต้นสร้างพื้นฐานที่แข็งแกร่งของคุณกันเลยครับ! 💪
ส่วนที่ 1: ศัพท์พื้นฐานด้านการพัฒนาซอฟต์แวร์และโค้ด
1. API (Application Programming Interface)
API คือตัวกลางในการสื่อสารระหว่างซอฟต์แวร์หรือแอปพลิเคชันต่างๆ ลองจินตนาการว่า API เปรียบเหมือนพนักงานเสิร์ฟในร้านอาหาร 🍽️ คุณ (แอปพลิเคชัน) ไม่ได้เข้าไปในครัว (ระบบหลังบ้าน) โดยตรง แต่คุณบอกพนักงานเสิร์ฟ (API) ว่าต้องการอะไร แล้วพนักงานเสิร์ฟจะไปสื่อสารกับครัวและนำอาหาร (ข้อมูล) มาให้คุณ การใช้ API ทำให้แอปต่างๆ สามารถแลกเปลี่ยนข้อมูลและทำงานร่วมกันได้อย่างราบรื่นโดยไม่ต้องรู้รายละเอียดภายในของกันและกัน
2. Repository (Repo)
Repository หรือที่เรียกสั้นๆ ว่า Repo คือที่เก็บโค้ดของโปรเจกต์ เหมือนเป็นคลังเก็บเอกสารดิจิทัลที่รวบรวมไฟล์โค้ด ประวัติการแก้ไข และข้อมูลต่างๆ ของโปรเจกต์ไว้ทั้งหมด 📦 เครื่องมือที่ใช้จัดการ Repository ที่นิยมมากที่สุด ได้แก่ Git, GitHub และ GitLab ซึ่งช่วยให้ทีมสามารถทำงานร่วมกันได้โดยไม่กลัวโค้ดหายหรือทับกัน การมี Repository ที่ดีจะช่วยให้การทำงานเป็นระบบและสามารถย้อนกลับไปดูหรือแก้ไขเวอร์ชันเก่าได้ทุกเมื่อ
3. Version Control (Git)
Version Control คือระบบติดตามประวัติการเปลี่ยนแปลงของโค้ด โดยเฉพาะ Git ที่เป็นเครื่องมือ Version Control ยอดนิยม 🔄 ลองนึกภาพว่าคุณกำลังเขียนรายงานและมีการบันทึกเป็น “รายงาน_ฉบับที่1.docx”, “รายงาน_ฉบับที่2_แก้ไข.docx”, “รายงาน_ฉบับสุดท้าย.docx” Git ทำหน้าที่คล้ายกันแต่ชาญฉลาดกว่ามาก โดยจะจดจำทุกการเปลี่ยนแปลง ใครแก้อะไร เมื่อไหร่ และสามารถย้อนกลับไปยังจุดใดก็ได้ ประโยชน์สำคัญคือช่วยให้ทีมทำงานร่วมกันได้โดยไม่เกิดความสับสนหรือโค้ดทับกัน พร้อมทั้งสามารถทดลองฟีเจอร์ใหม่ได้โดยไม่กลัวทำโค้ดหลักพัง
4. Front-end vs. Back-end
Front-end และ Back-end เปรียบเหมือนร้านอาหาร Front-end คือหน้าร้าน ที่ลูกค้าเห็นและโต้ตอบได้ เช่น การออกแบบตกแต่ง เมนูอาหาร โต๊ะเก้าอี้ ซึ่งเกี่ยวข้องกับ UI/UX ส่วน Back-end คือครัวหลังบ้าน ที่จัดการเรื่อง Logic, Database, และการประมวลผลข้อมูล 🏪 นักพัฒนา Front-end จะทำงานกับสิ่งที่ผู้ใช้เห็นและสัมผัสได้บนหน้าเว็บหรือแอป (HTML, CSS, JavaScript) ในขณะที่นักพัฒนา Back-end จะดูแลระบบที่อยู่เบื้องหลัง เช่น Server, Database, และ API ทั้งสองส่วนต้องทำงานประสานกันเพื่อให้แอปพลิเคชันทำงานได้อย่างสมบูรณ์
5. Database (DB)
Database หรือ DB คือคลังข้อมูลที่จัดเก็บข้อมูลอย่างเป็นระบบและมีโครงสร้าง 🗄️ เปรียบเหมือนตู้เก็บเอกสารขนาดยักษ์ที่จัดหมวดหมู่เป็นระเบียบ ทำให้สามารถค้นหา เพิ่ม แก้ไข หรือลบข้อมูลได้อย่างรวดเร็วและมีประสิทธิภาพ ตัวอย่างข้อมูลที่เก็บใน Database เช่น ข้อมูลผู้ใช้งาน (ชื่อ, อีเมล, รหัสผ่าน), ประวัติการสั่งซื้อสินค้า, โพสต์บนโซเชียลมีเดีย หรือข้อมูลการเงิน Database มีหลายประเภท เช่น SQL (MySQL, PostgreSQL) และ NoSQL (MongoDB) แต่ละประเภทเหมาะกับการใช้งานที่แตกต่างกัน
6. Environment (Dev, Staging, Prod)
Environment หมายถึงสภาพแวดล้อมหรือพื้นที่ที่ซอฟต์แวร์ทำงาน โดยแบ่งออกเป็น 3 ระยะหลัก 🏗️
- Dev (Development) คือระยะพัฒนาที่นักพัฒนาเขียนและทดสอบโค้ดบนเครื่องของตัวเอง
- Staging คือระยะทดสอบที่เลียนแบบสภาพแวดล้อมจริงเพื่อตรวจสอบว่าทุกอย่างทำงานถูกต้องก่อนเผยแพร่
- Prod (Production) คือระบบที่ใช้งานจริงที่ผู้ใช้ทั่วไปเข้าถึงได้
การแยก Environment ช่วยลดความเสี่ยงของ Bug ที่จะเกิดกับผู้ใช้จริง เพราะเราสามารถทดสอบและแก้ไขปัญหาใน Dev และ Staging ก่อนส่งไป Prod
7. Framework vs. Library
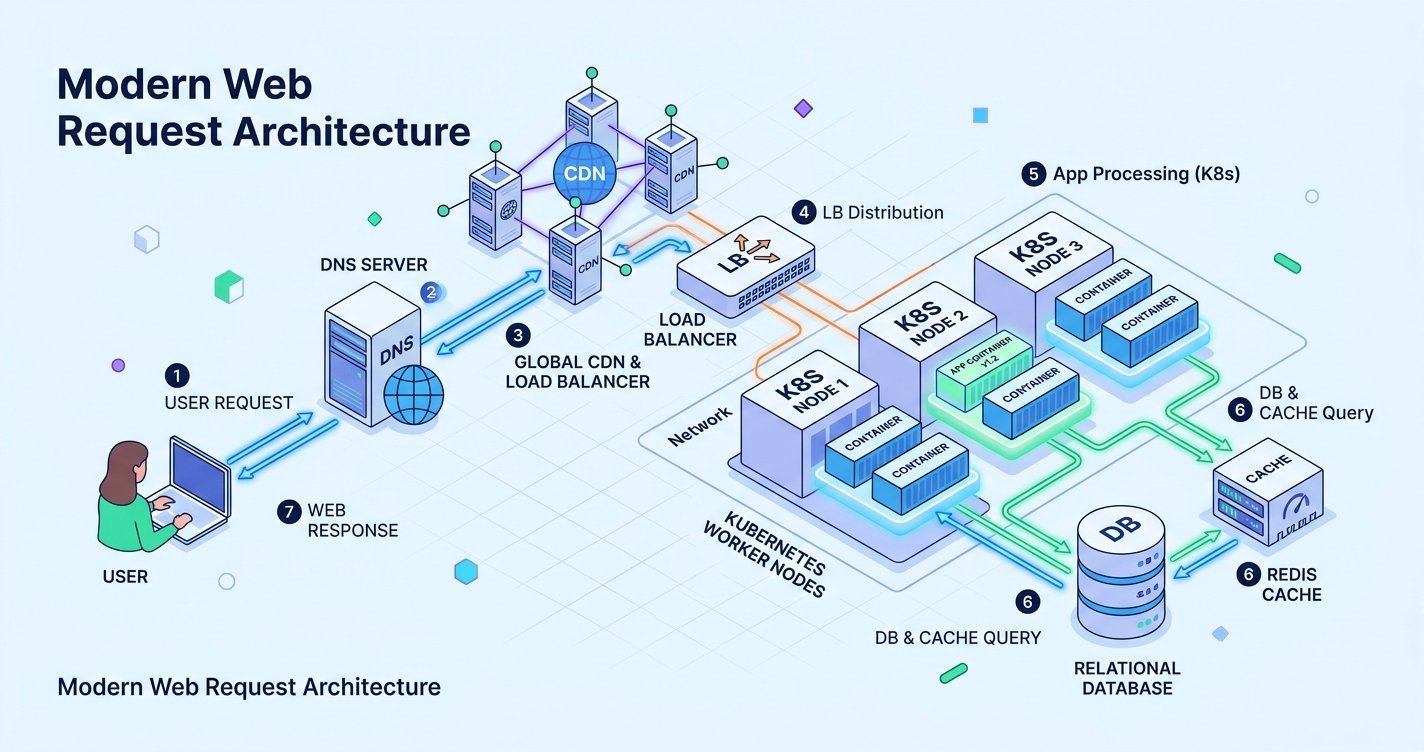
Framework และ Library ต่างก็เป็นเครื่องมือที่ช่วยให้นักพัฒนาทำงานได้เร็วขึ้น แต่มีความแตกต่างกัน 🛠️ Framework เปรียบเหมือนโครงสร้างหลักของบ้าน ที่มีกฎเกณฑ์และรูปแบบการทำงานที่ชัดเจน คุณต้องทำงานตามโครงสร้างที่ Framework กำหนดไว้ ส่วน Library เปรียบเหมือนกล่องเครื่องมือ ที่คุณสามารถหยิบมาใช้เมื่อต้องการโดยไม่ต้องปรับโครงสร้างโปรเจกต์ ตัวอย่าง Framework ได้แก่ React, Angular, Django ซึ่งแต่ละตัวมีแนวทางการทำงานเฉพาะตัว ในขณะที่ Library อาจเป็นชุดฟังก์ชันเล็กๆ ที่เรียกใช้ตามต้องการ
8. Refactoring
Refactoring คือการปรับโครงสร้างโค้ดให้สะอาด อ่านง่าย และมีประสิทธิภาพมากขึ้น โดยไม่เปลี่ยนแปลงการทำงานหรือผลลัพธ์ของโค้ดนั้นๆ 🧹 เปรียบเหมือนการจัดระเบียบบ้านใหม่โดยไม่ได้เปลี่ยนของที่มีอยู่ แค่จัดให้เป็นระเบียบและหาของง่ายขึ้น การ Refactoring เป็นสิ่งสำคัญเพราะช่วยลด Technical Debt ทำให้โค้ดดูแลรักษาง่ายขึ้น และลดโอกาสเกิด Bug ในอนาคต นักพัฒนามืออาชีพมักจะทำ Refactoring เป็นประจำเพื่อให้โค้ดเบสมีคุณภาพอยู่เสมอ แม้ว่าจะไม่ได้เพิ่มฟีเจอร์ใหม่ก็ตาม
9. Debugging
Debugging คือกระบวนการค้นหาและแก้ไข Bug (ข้อผิดพลาดในโค้ด) 🐛 เมื่อโปรแกรมทำงานไม่ตามที่คาดหวัง นักพัฒนาจะต้องทำการ Debug เพื่อหาสาเหตุว่าเกิดอะไรขึ้น ผิดพลาดตรงไหน และแก้ไขให้ถูกต้อง เครื่องมือที่ช่วยในการ Debugging มีมากมาย เช่น Visual Studio Code Debugger ที่ช่วยให้เราสามารถหยุดการทำงานของโปรแกรมตรงจุดที่ต้องการ ตรวจสอบค่าตัวแปร และติดตามการทำงานทีละขั้นตอน ทักษะ Debugging ที่ดีจะช่วยประหยัดเวลาในการแก้ปัญหาได้อย่างมาก
10. Legacy Code
Legacy Code คือโค้ดเก่าที่เขียนมาแล้วนาน อาจจะไม่มีเอกสารชัดเจน ใช้เทคโนโลยีที่ล้าสมัย หรือไม่มีคนที่เข้าใจโค้ดนั้นอยู่ในทีมแล้ว 📜 แม้ว่า Legacy Code จะยังทำงานได้ แต่การดูแลรักษาและพัฒนาต่อยอดมักจะท้าทายเพราะโครงสร้างอาจไม่เป็นระบบหรือยากต่อการเข้าใจ หลายบริษัทต้องจัดการกับ Legacy Code เพราะไม่สามารถเขียนใหม่ทั้งหมดได้ในคราวเดียว ดังนั้นทักษะการอ่านและปรับปรุง Legacy Code จึงเป็นทักษะที่มีค่ามากในวงการเทค
ส่วนที่ 2: ศัพท์พื้นฐานด้านกระบวนการทำงานและโครงการ
11. Agile & Scrum
Agile คือแนวคิดหรือ Mindset ในการทำงานที่เน้นความยืดหยุ่นและการปรับตัวอย่างรวดเร็ว ส่วน Scrum คือหนึ่งใน Framework ที่ใช้ปฏิบัติตามแนวคิด Agile 🔄 แทนที่จะวางแผนโปรเจกต์ทั้งหมดตั้งแต่ต้นแล้วค่อยส่งมอบในตอนท้าย Agile เน้นการส่งมอบงานเป็นช่วงสั้นๆ และรับ Feedback เพื่อปรับปรุงอย่างต่อเนื่อง Scrum แบ่งงานเป็น Sprint พร้อมมีบทบาทชัดเจนเช่น Scrum Master, Product Owner และ Development Team เครื่องมือที่ใช้ในการบริหาร Agile/Scrum ที่นิยม ได้แก่ Jira และ Trello ซึ่งช่วยให้ทีมติดตามงานและความคืบหน้าได้อย่างมีประสิทธิภาพ
12. Sprint
Sprint คือรอบการทำงานระยะสั้นใน Scrum โดยทั่วไปจะมีระยะเวลา 1-4 สัปดาห์ 🏃♂️ ในแต่ละ Sprint ทีมจะเลือกงานที่จะทำให้เสร็จภายในรอบนั้น และมุ่งเน้นไปที่เป้าหมายเฉพาะ เมื่อ Sprint จบลง ทีมจะมีผลงานที่สามารถใช้งานได้จริง (Potentially Shippable Product) พร้อม Demo ให้ Stakeholder ดู การทำงานเป็น Sprint ช่วยให้ทีมมีจังหวะในการทำงาน สามารถวัดความก้าวหน้าได้ชัดเจน และปรับทิศทางได้ทันท่วงทีหากมีการเปลี่ยนแปลงจากตลาดหรือความต้องการของลูกค้า
13. Daily Stand-up
Daily Stand-up หรือที่เรียกว่า Daily Scrum คือการประชุมสั้นๆ ประมาณ 15 นาที ที่ทีมจะทำทุกเช้า ☀️ สมาชิกทุกคนจะยืนประชุม (เพื่อให้จบเร็ว) และแชร์ข้อมูล 3 ประเด็น คือ เมื่อวานทำอะไรไปบ้าง (What I did yesterday), วันนี้จะทำอะไร (What I’ll do today) และ มีอุปสรรคอะไรหรือไม่ (Any Blocker) การประชุมนี้ไม่ใช่การรายงานตัวให้หัวหน้าฟัง แต่เป็นการให้ทีมรู้ว่าทุกคนกำลังทำอะไรอยู่ หากมีปัญหาก็สามารถช่วยเหลือกันได้ทันที ช่วยให้ทีมมีการสื่อสารที่ดีและทำงานประสานกันได้อย่างมีประสิทธิภาพ
14. User Story
User Story คือการอธิบายความต้องการของลูกค้าหรือผู้ใช้ในมุมมองของผู้ใช้เอง 📖 โดยทั่วไปจะเขียนในรูปแบบ “ในฐานะ [ผู้ใช้] ฉันต้องการ [ฟีเจอร์] เพื่อที่จะ [เป้าหมาย]” เช่น “ในฐานะลูกค้า ฉันต้องการกดสั่งซื้อสินค้าได้ผ่านแอป เพื่อที่จะประหยัดเวลาในการเดินทางไปร้าน” User Story ช่วยให้ทีมเข้าใจว่าทำไมต้องสร้างฟีเจอร์นี้ และสร้างอะไรที่ตอบโจทย์ผู้ใช้จริงๆ แทนที่จะสร้างตามสเปคทางเทคนิคเพียงอย่างเดียว การเขียน User Story ที่ดีจะทำให้ทีมพัฒนาผลิตภัณฑ์ที่ผู้ใช้ต้องการจริงๆ
15. Retrospective (Retro)
Retrospective หรือ Retro คือการประชุมทบทวนหลังจากจบ Sprint เพื่อหาจุดที่ทำได้ดีและจุดที่ควรปรับปรุง 🔍 ทีมจะนั่งคุยกันอย่างเปิดเผยและสร้างสรรค์ว่า “อะไรที่เราทำได้ดี (What went well)”, “อะไรที่ควรปรับปรุง (What could be improved)” และ “เราจะทำอะไรต่อไปในรอบหน้า (Action items)” Retro เป็นหัวใจสำคัญของการเรียนรู้และพัฒนาอย่างต่อเนื่อง เพราะทำให้ทีมไม่ได้แค่ทำงานไปวันๆ แต่ยังพัฒนาวิธีการทำงานให้ดีขึ้นเรื่อยๆ บรรยากาศของ Retro ควรเป็นแบบปลอดภัยทางจิตใจ (Psychological Safety) เพื่อให้ทุกคนกล้าพูดความจริง
16. Blocker
Blocker คือสิ่งกีดขวางหรืออุปสรรคที่ทำให้ไม่สามารถทำงานต่อได้หรือทำให้ความคืบหน้าหยุดชะงัก 🚧 ตัวอย่าง Blocker เช่น รอข้อมูลจากทีมอื่น, API ที่ยังไม่พร้อมใช้งาน, Bug ที่ต้องแก้ก่อนถึงจะทำงานชิ้นนี้ต่อได้, หรือเครื่อง Server ล่ม ในการประชุม Daily Stand-up หากมี Blocker จะต้องแจ้งให้ทีมรู้เพื่อหาทางแก้ไขโดยเร็ว การจัดการ Blocker อย่างมีประสิทธิภาพเป็นกุญแจสำคัญในการทำให้ทีมทำงานได้ราบรื่นและส่งมอบงานได้ตามกำหนด
17. Kanban
Kanban คือระบบบริหารงานด้วยภาพ (Visual Management) ที่ใช้บอร์ดแสดงสถานะงานต่างๆ 📋 โดยทั่วไปจะแบ่งเป็นคอลัมน์ เช่น “To Do” (รอทำ), “In Progress” (กำลังทำ), “Done” (เสร็จแล้ว) การ์ดแต่ละใบแทนงานหนึ่งชิ้นที่จะเคลื่อนผ่านแต่ละคอลัมน์ตามความคืบหน้า จุดเด่นของ Kanban คือการใช้ WIP Limit (Work In Progress Limit) คือการจำกัดจำนวนงานที่ทำพร้อมกันได้ในแต่ละคอลัมน์ เพื่อป้องกันไม่ให้ทีมรับงานมากเกินไปจนทำไม่ทัน Kanban เหมาะกับงานที่มีลักษณะ Continuous Flow มากกว่างานแบบ Sprint
18. Tech Stack
Tech Stack คือชุดเทคโนโลยีทั้งหมดที่ใช้ในการสร้างผลิตภัณฑ์ซอฟต์แวร์หรือแอปพลิเคชัน 🥞 ประกอบด้วย
- Front-end (เช่น React, Vue.js)
- Back-end (เช่น Node.js, Python, Ruby)
- Database (เช่น PostgreSQL, MongoDB)
- Infrastructure (เช่น AWS, Docker)
- เครื่องมือต่างๆ ที่ใช้ในการพัฒนา
การเลือก Tech Stack ที่เหมาะสมขึ้นอยู่กับลักษณะของโปรเจกต์ ทักษะของทีม และข้อจำกัดต่างๆ เช่น งบประมาณหรือเวลา การเข้าใจ Tech Stack ช่วยให้นักพัฒนารู้ว่าต้องเรียนรู้เทคโนโลยีไหนบ้างเพื่อทำงานกับโปรเจกต์นั้นๆ
19. MVP (Minimum Viable Product)
MVP หรือ Minimum Viable Product คือผลิตภัณฑ์เวอร์ชันเล็กที่สุดที่ยังใช้งานได้และตอบโจทย์หลักของผู้ใช้ 🚀 แนวคิดของ MVP คือการไม่ต้องสร้างทุกฟีเจอร์ให้สมบูรณ์แบบตั้งแต่แรก แต่สร้างแค่ฟีเจอร์หลักที่จำเป็นที่สุดก่อน แล้วนำออกให้ผู้ใช้ทดลองใช้และรับ Feedback เพื่อปรับปรุงต่อ การทำ MVP ช่วยประหยัดเวลาและต้นทุน ลดความเสี่ยงในการสร้างผลิตภัณฑ์ที่ไม่มีใครต้องการ และเรียนรู้จากผู้ใช้จริงว่าควรพัฒนาอะไรต่อไป แทนที่จะใช้เวลาหลายปีสร้างผลิตภัณฑ์สมบูรณ์แล้วค่อยค้นพบว่าตลาดไม่ต้องการ
20. Technical Debt
Technical Debt หรือหนี้ทางเทคนิค คือผลที่ตามมาจากการเลือกแก้ปัญหาแบบง่ายและรวดเร็วในระยะสั้น แต่สร้างภาระในระยะยาว 💳 เปรียบเหมือนการกอดหนี้ แม้จะได้เงินมาใช้เร็วในตอนนี้ แต่ในอนาคตต้องใช้เวลาและทรัพยากรมากขึ้นในการจ่ายคืนพร้อมดอกเบี้ย
ตัวอย่าง Technical Debt เช่น
- เขียนโค้ดแบบทางลัดที่อ่านยาก
- ข้าม Unit Test เพื่อส่งงานให้ทันกำหนด
- ใช้เทคโนโลยีที่ไม่เหมาะสม
เมื่อ Technical Debt สะสมมากขึ้น การพัฒนาฟีเจอร์ใหม่จะช้าลง Bug เกิดบ่อยขึ้น และทีมต้องใช้เวลาแก้ปัญหามากขึ้น การจัดการ Technical Debt อย่างสม่ำเสมอจึงเป็นสิ่งสำคัญ
ส่วนที่ 3: ศัพท์พื้นฐานด้านโครงสร้างและการจัดการ
21. Cloud Computing
Cloud Computing คือการประมวลผลบนคลาวด์ หรือการใช้ทรัพยากรคอมพิวเตอร์ผ่านอินเทอร์เน็ตแทนที่จะมี Server ตั้งอยู่ในออฟฟิศของตัวเอง ☁️ เปรียบเหมือนการเช่าใช้ไฟฟ้าจากการไฟฟ้าแทนที่จะสร้างโรงไฟฟ้าเป็นของตัวเอง ผู้ให้บริการ Cloud ยอดนิยม ได้แก่
- AWS (Amazon Web Services)
- Google Cloud Platform
- Microsoft Azure
ข้อดีของ Cloud Computing คือสามารถขยายทรัพยากรได้ตามต้องการ (Scalability), ประหยัดต้นทุนเพราะจ่ายตามการใช้งานจริง, เข้าถึงได้จากทุกที่ และมีความปลอดภัยสูงจากผู้ให้บริการที่เป็นมืออาชีพ
22. Serverless
Serverless ไม่ได้แปลว่าไม่มี Server จริงๆ อยู่ในโลก แต่มันหมายถึงรูปแบบที่เราในฐานะนักพัฒนา “ไม่ต้องมาคอยดูแลหรือตั้งค่า Server เอง” เลยแม้แต่น้อย หน้าที่เรามีเพียงเขียนโค้ดฟังก์ชันแล้วอัปโหลดขึ้นไประบบ (เช่น AWS Lambda หรือ Cloudflare Workers) เมื่อมีคนเรียกใช้งาน ระบบจะปลุกโค้ดขึ้นมาประมวลผลทันที และคิดค่าบริการตามเวลาที่โค้ดทำงานจริงระดับมิลลิวินาที เมื่อไม่มีคนใช้ก็ไม่ต้องจ่ายเงินสักบาท
23. Container & Docker
เคยเจอปัญหานี้ไหมครับ? “บนเครื่องผมรันผ่านนะ แต่ทำไมบนเซิร์ฟเวอร์รันไม่ผ่าน?” Docker เข้ามาแก้ปัญหานี้ด้วยแนวคิด Container ซึ่งเปรียบเหมือนการแพ็กแอปพลิเคชัน โค้ด รันไทม์ และการตั้งค่าทั้งหมดลงในกล่องตู้คอนเทนเนอร์มาตรฐานเดียวกัน ทำให้มั่นใจได้ว่า ไม่ว่าจะนำกล่องนี้ไปวางรันบนแล็ปท็อปของคุณ หรือเครื่อง Cloud ของลูกค้า มันจะทำงานได้ผลลัพธ์เหมือนกัน 100%
24. Kubernetes (K8s)
ถ้า Docker เปรียบเหมือนตู้คอนเทนเนอร์ Kubernetes (หรือเรียกย่อๆ ว่า K8s) ก็คือ “เรือบรรทุกสินค้าและระบบจัดการท่าเรือ” ขนาดยักษ์ เมื่อระบบของคุณเริ่มโตขึ้นจนมีตู้คอนเทนเนอร์เป็นร้อยๆ ตู้ K8s จะทำหน้าที่ควบคุมอัตโนมัติ (Orchestration) เช่น ช่วยจัดสรรตู้ คอยตรวจสอบว่าตู้ไหนพังแล้วสตาร์ทขึ้นมาใหม่แทนที่ทันที รวมถึงช่วยขยายจำนวนตู้เวลามีคนแห่เข้ามาใช้งานเยอะๆ
25. CI/CD (Continuous Integration / Continuous Deployment)
CI/CD คือแนวคิดและท่อส่งอัตโนมัติ (Pipeline) สำหรับการส่งมอบซอฟต์แวร์
- CI (Continuous Integration): ทุกครั้งที่นักพัฒนา Push โค้ดใหม่เข้า Git ระบบจะดึงโค้ดไปประกอบร่างและรันแบบทดสอบอัตโนมัติ เพื่อเช็กว่าโค้ดใหม่ไม่ไปทำระบบเดิมพัง
- CD (Continuous Deployment / Delivery): เมื่อแบบทดสอบผ่านฉลุย ระบบจะนำโค้ดเวอร์ชันล่าสุดขึ้น Production ให้ผู้ใช้ใช้งานได้ทันทีโดยไม่ต้องมีคนมาคอยกด Deploy ทีละขั้นตอนด้วยมือ
26. Microservices vs. Monolith
สองสถาปัตยกรรมระบบยอดฮิตที่มักถูกนำมาถกเถียงกัน:
- Monolith: ระบบแบบ “ก้อนเดียวจบ” ทุกฟีเจอร์ตั้งแต่ระบบล็อกอิน จัดการตะกร้าสินค้า ชำระเงิน อยู่ในโค้ดเบสเดียวกัน ข้อดีคือเริ่มสร้างง่ายและตรวจสอบง่ายในช่วงแรก แต่เมื่อระบบใหญ่มากจะเริ่มแก้ไขยากและกระทบกันหมด
- Microservices: การหั่นระบบใหญ่ออกเป็นบริการย่อยๆ ที่ทำงานอิสระต่อกันและสื่อสารกันผ่าน API เช่น เซอร์วิสชำระเงินล่ม เซอร์วิสค้นหาสินค้าก็ยังทำงานต่อได้ ทำให้ทีมขนาดใหญ่แยกกันพัฒนาได้อย่างคล่องตัว
27. Load Balancer
ลองจินตนาการถึงเจ้าหน้าที่คอยแจกบัตรคิวและจัดคนเข้าช่องบริการในธนาคาร Load Balancer ทำหน้าที่แบบเดียวกันบนโลกไอที คือคอยดักรับ Traffic ปริมาณมหาศาลจากผู้ใช้ แล้วกระจายคำขอเหล่านั้นไปยังเซิร์ฟเวอร์หลายๆ เครื่องอย่างสมดุล เพื่อป้องกันไม่ให้เครื่องใดเครื่องหนึ่งรับโหลดหนักจนล่มไป
28. DNS (Domain Name System)
DNS เปรียบเสมือน “สมุดโทรศัพท์ของโลกอินเทอร์เน็ต” เพราะคอมพิวเตอร์คุยกันด้วยตัวเลข IP Address (เช่น 192.0.2.1) แต่มนุษย์จำตัวเลขยาก DNS จึงทำหน้าที่แปลงชื่อโดเมนที่อ่านง่ายอย่าง technolista.com ให้กลายเป็นหมายเลข IP ปลายทางที่ถูกต้องเพื่อให้เบราว์เซอร์พาเราไปถูกที่
29. CDN (Content Delivery Network)
CDN คือเครือข่ายของเซิร์ฟเวอร์กระจายตัวอยู่ทั่วทุกมุมโลก ทำหน้าที่คัดลอกไฟล์รูปภาพ วิดีโอ หรือหน้าเว็บแบบสถิต (Static Assets) ไปเก็บไว้ที่เซิร์ฟเวอร์สาขาที่ใกล้ผู้ใช้ที่สุด ตัวอย่างเช่น หากเซิร์ฟเวอร์หลักของคุณอยู่อเมริกา แต่ผู้ใช้อยู่กรุงเทพฯ CDN จะดึงไฟล์จาก Edge Server ในสิงคโปร์หรือไทยมาส่งให้ทันที ทำให้เว็บเปิดเร็วขึ้นมหาศาล
30. Observability & Monitoring (Logs, Metrics, Traces)
เมื่อระบบทำงานบนโปรดักชัน เราไม่สามารถเปิดดูหน้าจอเซิร์ฟเวอร์ได้ตลอดเวลา Observability คือความสามารถในการเข้าใจว่าระบบข้างในเกิดอะไรขึ้น ผ่านเสาหลัก 3 ต้น:
- Logs: บันทึกประวัติเหตุการณ์ เช่น “ผู้ใช้ ID 50 ล็อกอินเวลา 10:00”
- Metrics: ตัวเลขสถิติภาพรวม เช่น การใช้งาน CPU กี่เปอร์เซ็นต์ หรือมีคำขอเข้ามาวินาทีละเท่าไหร่
- Traces: การแกะรอยการเดินทางของคำขอหนึ่งๆ ตั้งแต่ต้นจนจบว่าแวะผ่านเซอร์วิสไหนบ้างและติดช้าที่จุดใด
ส่วนที่ 4: ศัพท์ด้านข้อมูล ความปลอดภัย และระบบหลังบ้าน
31. SQL vs. NoSQL
ฐานข้อมูล (Database) แบ่งออกเป็นสองกลุ่มใหญ่ตามวิธีการจัดเก็บข้อมูล:
- SQL (Relational): เก็บข้อมูลเป็นตารางแถวและคอลัมน์ที่มีโครงสร้างชัดเจนและเชื่อมโยงกันได้ (เช่น MySQL, PostgreSQL) เหมาะกับข้อมูลที่ต้องการความถูกต้องแม่นยำสูง เช่น ข้อมูลการเงิน
- NoSQL (Non-relational): เก็บข้อมูลแบบยืดหยุ่น เช่น เก็บเป็นเอกสาร JSON หรือ Key-Value (เช่น MongoDB, DynamoDB) เหมาะกับข้อมูลที่มีความหลากหลายและต้องการขยายสเกลในแนวนอนได้ง่าย
32. Authentication vs. Authorization (AuthN vs. AuthZ)
สองคำที่มักพูดติดกันจนสับสน แต่หน้าที่ต่างกันชัดเจน:
- Authentication (AuthN): “คุณคือใคร?” เช่น การกรอกชื่อผู้ใช้และรหัสผ่าน หรือสแกนลายนิ้วมือเพื่อยืนยันตัวตน
- Authorization (AuthZ): “คุณมีสิทธิ์ทำอะไรได้บ้าง?” หลังจากยืนยันตัวตนแล้ว ระบบจะตรวจสอบต่อว่าคุณได้รับสิทธิ์เข้าถึงหน้านี้หรือไม่ เช่น เป็นแค่ผู้ใช้งานทั่วไป หรือเป็นแอดมินที่มีสิทธิ์ลบข้อมูล
33. Token & JWT (JSON Web Token)
JWT คือตั๋วผ่านประตูอิเล็กทรอนิกส์ในรูปแบบข้อความยาวๆ ที่เข้ารหัสไว้ เมื่อคุณล็อกอินผ่าน เซิร์ฟเวอร์จะออก Token นี้ให้เบราว์เซอร์เก็บไว้ ทุกครั้งที่คุณคลิกเปิดหน้าใหม่ เบราว์เซอร์จะแนบ Token นี้ไปแสดงตน เซิร์ฟเวอร์เพียงตรวจลายเซ็นดิจิทัลบน Token ก็รู้ได้ทันทีว่าคุณคือใครโดยไม่ต้องย้อนไปค้นฐานข้อมูลซ้ำๆ
34. Encryption vs. Hashing
ความปลอดภัยของข้อมูลสองรูปแบบที่มือใหม่มักเข้าใจสลับกัน:
- Encryption (การเข้ารหัสแบบสองทาง): แปลงข้อความให้อ่านไม่ออก โดยผู้ที่มีกุญแจ (Key) สามารถถอดรหัส (Decrypt) กลับมาเป็นข้อความเดิมได้ เช่น การส่งข้อความแชต
- Hashing (การแปลงข้อมูลทางเดียว): นำรหัสผ่านไปปั่นเป็นข้อความรหัสที่มีความยาวคงที่ ซึ่งไม่สามารถแปลงย้อนกลับได้ ระบบจะใช้วิธีนี้เก็บรหัสผ่านเพื่อป้องกันข้อมูลรั่วไหล
35. SSL/TLS & HTTPS
HTTPS คือการเชื่อมต่อเว็บที่ปลอดภัย สัญลักษณ์แม่กุญแจสีเขียวบนเบราว์เซอร์ โดยทำงานผ่านโพรโทคอล TLS (หรือชื่อเก่าคือ SSL) ทำหน้าที่เข้ารหัสข้อมูลทุกอย่างที่ส่งระหว่างเครื่องของคุณกับเซิร์ฟเวอร์ เพื่อป้องกันผู้ไม่หวังดีดักจับรหัสผ่านหรือข้อมูลบัตรเครดิตขณะใช้งานผ่าน Wi-Fi สาธารณะ
36. Firewall
Firewall เปรียบเสมือน “ป้อมยามหน้าหมู่บ้าน” ที่คอยตรวจสอบและคัดกรองข้อมูลเครือข่ายที่ไหลเข้า-ออกจากเซิร์ฟเวอร์ โดยจะอนุญาตให้เฉพาะข้อมูลจากพอร์ตหรือ IP ที่ปลอดภัยผ่านเข้ามาได้เท่านั้น และจะสั่งบล็อกคำขอที่มีพฤติกรรมน่าสงสัยหรืออันตรายทันที
37. Data Pipeline & ETL (Extract, Transform, Load)
ETL คือกระบวนการจัดการข้อมูลขนาดใหญ่ที่ต้องรวบรวมจากหลายแหล่ง:
- Extract: สกัดดึงข้อมูลดิบออกมาจากแหล่งต่างๆ เช่น ฐานข้อมูลร้านค้า หรือ Google Analytics
- Transform: ปรับแต่ง จัดระเบียบ คลีนข้อมูล และคำนวณให้อยู่ในฟอร์แมตมาตรฐานเดียวกัน
- Load: โหลดข้อมูลที่พร้อมใช้งานเข้าไปยังคลังข้อมูลส่วนกลาง (Data Warehouse) เพื่อให้ทีมธุรกิจนำไปวิเคราะห์ต่อ
38. Webhook
ถ้า API แบบเดิมเปรียบเหมือนการที่คุณต้องคอยโทรถามร้านอาหารทุก 5 นาทีว่า “อาหารเสร็จหรือยัง?” Webhook ก็คือการบอกเบอร์โทรของคุณทิ้งไว้ แล้วให้ทางร้านโทรกลับมาบอกเองเมื่ออาหารเสร็จทันที เป็นการส่งข้อมูลแบบ Real-time ตามเหตุการณ์ที่เกิดขึ้นจริง (Event-driven)
39. Cache & Redis
Cache คือหน่วยความจำชั่วคราวความเร็วสูง เปรียบเหมือนโต๊ะทำงานที่คุณหยิบเอกสารที่ใช้บ่อยมาวางไว้ตรงหน้า แทนที่จะเดินไปรื้อค้นจากตู้เก็บเอกสาร (Database) ทุกรอบ เครื่องมือยอดนิยมอย่าง Redis จะเก็บข้อมูลไว้บน RAM ทำให้ดึงข้อมูลตอบกลับผู้ใช้ได้เร็วระดับเสี้ยววินาที
40. Rate Limiting
Rate Limiting คือมาตรการจำกัดจำนวนครั้งที่ผู้ใช้หรือโปรแกรมสามารถเรียกใช้งาน API หรือระบบได้ภายในระยะเวลาที่กำหนด เช่น อนุญาตให้เรียกได้ไม่เกิน 60 ครั้งต่อนาที เพื่อป้องกันการโจมตีแบบยิงถล่มระบบ (DDoS) และป้องกันไม่ให้มีบอทแอบมาดูดข้อมูลระบบไป
ส่วนที่ 5: ศัพท์ยุค AI, การทำงานร่วมกัน และคำสแลงในทีมเทค
41. LLM (Large Language Model)
LLM คือโมเดลปัญญาประดิษฐ์ขนาดใหญ่ที่ผ่านการฝึกฝนด้วยชุดข้อมูลข้อความมหาศาลจากอินเทอร์เน็ต ทำให้มีความสามารถในการทำความเข้าใจ สรุปความ แปลภาษา และเขียนโค้ดคอมพิวเตอร์ได้อย่างเป็นธรรมชาติ เช่น โมเดลเบื้องหลัง ChatGPT หรือ Claude
42. Context Window & Token
ในการทำงานร่วมกับ AI คุณมักจะได้ยินคำว่า Token ซึ่งเปรียบเสมือนชิ้นส่วนคำหรือตัวอักษรที่ AI ใช้คิดเงินและประมวลผล ส่วน Context Window คือ “ความจุของสมองระยะสั้น” ของ AI ในบทสนทนานั้นๆ หากเราป้อนข้อความยาวเกิน Context Window โมเดลจะเริ่มหลงลืมเนื้อหาในส่วนแรกๆ ไป
43. AI Agent
แตกต่างจาก Chatbot ทั่วไปที่ทำได้แค่ตอบคำถาม AI Agent คือระบบปัญญาประดิษฐ์ที่มีเป้าหมายชัดเจน สามารถคิดวางแผนขั้นตอนด้วยตัวเอง และมีความสามารถในการเรียกใช้เครื่องมือภายนอก (Tools) เช่น เรียกดูไฟล์ ค้นหาเว็บ หรือรันสคริปต์ใน Terminal เพื่อแก้ปัญหาจนสำเร็จได้แบบอัตโนมัติ
44. Code Review & PR (Pull Request)
Pull Request (PR) หรือ Merge Request คือการส่งคำขอให้เพื่อนร่วมทีมนำโค้ดใหม่ของคุณรวมเข้าสู่กิ่งหลัก (Main Branch) และในระหว่างนี้จะเกิดขั้นตอน Code Review ซึ่งเพื่อนร่วมทีมหรือ Senior จะเข้ามาอ่านโค้ดของคุณเพื่อตรวจหาบั๊ก แนะนำแนวทางที่กระชับขึ้น และรักษามาตรฐานความปลอดภัยร่วมกัน
45. Broken Build & CI Failure
เมื่อมีใครสักคนดันโค้ดที่มีข้อผิดพลาดเข้าไปจนระบบอัตโนมัติ (CI) ไม่สามารถคอมไพล์หรือรันเทสต์ผ่าน เราจะเรียกว่า Build พัง (Broken Build) ซึ่งถือเป็นเรื่องเร่งด่วนในทีมที่ทุกคนต้องช่วยกันหยุดและแก้ไข เพื่อไม่ให้กระทบกับการทำงานของเพื่อนร่วมทีมคนอื่นๆ
46. Hotfix
Hotfix คือการแก้ไขปัญหาแบบด่วนพิเศษบนระบบจริง (Production) ทันทีที่เจอบั๊กวิกฤต เช่น ระบบชำระเงินพัง โดยจะลัดขั้นตอนการพัฒนาตามรอบ Sprint ปกติ เพื่อปล่อยตัวแก้ออกไปกู้วิกฤตให้เร็วที่สุด
47. Deprecated
เวลาอ่านเอกสารเทคนิคแล้วเจอคำว่า Deprecated หมายถึงฟังก์ชัน ไลบรารี หรือโค้ดคำสั่งนั้น “ถูกประกาศเลิกสนับสนุนแล้ว” แม้ปัจจุบันจะยังพอใช้งานได้อยู่ แต่ทีมงานจะไม่พัฒนาต่อ และมีแผนจะลบออกอย่างถาวรในเวอร์ชันถัดไป จึงควรหลีกเลี่ยงการนำมาใช้ในโปรเจกต์ใหม่
48. Edge Case
Edge Case คือกรณีหรือสถานการณ์สุดโต่งที่ไม่ค่อยเกิดขึ้นในการใช้งานทั่วไป แต่มักเป็นจุดที่ทำให้ระบบพัง เช่น ฟอร์มกรอกชื่อผู้ใช้แต่มีคนใส่สัญลักษณ์พิเศษยาว 5,000 ตัวอักษร หรือระบบจองตั๋วที่มีคนกดซื้อพร้อมกันในเสี้ยววินาทีเดียวกัน
49. Bottleneck (คอขวด)
Bottleneck หมายถึงจุดที่ทำให้ประสิทธิภาพโดยรวมของระบบทำงานช้าลง เปรียบเหมือนคอขวดที่น้ำไหลผ่านได้จำกัด เช่น แม้เว็บเซิร์ฟเวอร์จะเร็วมาก แต่ถ้าฐานข้อมูลเขียนดิสก์ช้า ทั้งระบบก็ต้องหยุดรอที่ฐานข้อมูลนั้น
50. Imposter Syndrome & Growth Mindset
คำศัพท์สำคัญทางจิตวิทยาที่คนในวงการเทคทุกคนต้องเจอ Imposter Syndrome คือความรู้สึกว่าตัวเองเป็น “คนไม่เก่งตัวปลอม” ที่ฟลุ๊คเข้ามาได้ และกลัวคนอื่นจะจับได้ แต่ในความเป็นจริง วงการเทคโนโลยีเปลี่ยนแปลงทุกวัน ไม่มีใครรู้ทุกอย่าง สิ่งสำคัญคือการมี Growth Mindset ที่มองว่าความไม่รู้ไม่ใช่ความล้มเหลว แต่เป็นโอกาสในการเรียนรู้สิ่งใหม่ๆ เสมอ
บทสรุป: ก้าวสู่การทำงานจริงอย่างมั่นใจ
การเรียนรู้คำศัพท์เทคนิคทั้ง 50 คำนี้ ไม่ได้มีเป้าหมายเพื่อให้คุณท่องจำไปสอบ แต่เพื่อให้คุณเข้าใจ “ภาพรวม” และ “บริบท” ของการทำงานร่วมกันในทีมเทคโนโลยี เมื่อคุณคุยภาษาเดียวกับทีม ความกลัวในการตั้งคำถามจะลดลง ความเข้าใจในสถาปัตยกรรมระบบจะเพิ่มขึ้น และทำให้คุณเติบโตในสายอาชีพนี้ได้อย่างรวดเร็วและมั่นใจครับ 🚀